Domain nrp-online.de kaufen?
Wir ziehen mit dem Projekt
nrp-online.de um.
Sind Sie am Kauf der Domain
nrp-online.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain nrp-online.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
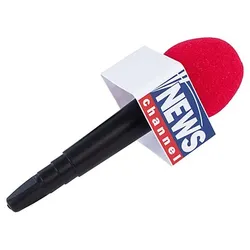
Mikrofon "Nachrichten"Mikrofon Nachrichten – Newsflash: Dieses Must-have dürfen sich fleißige Faschingsreporter nicht entgehen lassen!Besonderheiten: mit Aufschrift NEWS channelLieferumfang: MikrofonDetails: Kunststoff-Mikrofon mit SchaumstoffGrößenhinweis: 25 cmFarbe: rot/weiß/schwarzAls unerschrockener Reporter berichten Sie live und in Farbe über das aktuelle Faschingstreiben. Furchtlos interviewen Sie Geister und Dämonen, drehen Dokumentation über das Faschings-Tierreich oder decken Ungerechtigkeiten bei Hofe auf! Egal, für welche Story Sie sich entscheiden, mit Ihrem täuschend echt aussehenden Mikrofon erleben Sie bestimmt Faschingsabenteuer, über die es sich zu berichten lohnt!6,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
MICHEL-Redaktion, Ratgeber von MICHEL-RedaktionDer "Michel Südamerika A-J 2023/2024" Ratgeber, herausgegeben von der Michel-Redaktion, ist eine umfassende Informationsquelle über die Länder Südamerikas, darunter Argentinien, Bolivien, Brasilien, Chile, Ecuador und Französisch-Guyana. Mit 1170 Seiten bietet dieses Sachbuch detaillierte Einblicke in die Kultur, Geografie und Reiseinformationen der Region. Die Publikation ist in deutscher Sprache verfasst und eignet sich sowohl für Reisende als auch für Studierende und Interessierte. Die handliche Grösse und das robuste Design machen es zu einem praktischen Begleiter für unterwegs. Die Michel-Redaktion ist bekannt für ihre präzisen und gut recherchierten Inhalte, die eine wertvolle Unterstützung bei der Planung von Reisen und dem Verständnis der südamerikanischen Kultur bieten.82,60 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **


Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Langenscheidt Taschenwörterbuch Kroatisch - Buch mit online-Anbindung, Sprachbücher von Redaktion LangenscheidtDas Langenscheidt Taschenwörterbuch Kroatisch ist ein umfassendes Nachschlagewerk, das sich ideal für alle eignet, die die kroatische Sprache lernen oder ihre Kenntnisse vertiefen möchten. Mit rund 75.000 Stichwörtern und Wendungen deckt es eine Vielzahl von Themen ab, darunter Alltag, Kommunikation, Medien, Wirtschaft und Politik. Die aktuelle Neuwortschatzsammlung sorgt dafür, dass Nutzer stets mit den neuesten Begriffen vertraut sind. Zusätzlich bietet das Wörterbuch praktische Schreibvorlagen für E-Mails, Briefe, Bewerbungen und Lebensläufe sowie hilfreiche Grammatiktabellen und Zahlenübersichten. Die handliche Grösse macht es zu einem idealen Begleiter für unterwegs, während die Online-Anbindung den Zugriff auf zusätzliche Ressourcen ermöglicht. Dieses Wörterbuch ist nicht nur ein nützliches Lernwerkzeug, sondern auch ein wertvoller Begleiter für alle, die sich mit der kroatischen Sprache und Kultur auseinandersetzen möchten.36,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Mikrofon "Nachrichten"Mikrofon Nachrichten – Newsflash: Dieses Must-have dürfen sich fleißige Faschingsreporter nicht entgehen lassen!Besonderheiten: mit Aufschrift NEWS channelLieferumfang: MikrofonDetails: Kunststoff-Mikrofon mit SchaumstoffGrößenhinweis: 25 cmFarbe: rot/weiß/schwarzAls unerschrockener Reporter berichten Sie live und in Farbe über das aktuelle Faschingstreiben. Furchtlos interviewen Sie Geister und Dämonen, drehen Dokumentation über das Faschings-Tierreich oder decken Ungerechtigkeiten bei Hofe auf! Egal, für welche Story Sie sich entscheiden, mit Ihrem täuschend echt aussehenden Mikrofon erleben Sie bestimmt Faschingsabenteuer, über die es sich zu berichten lohnt!6,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
MICHEL-Redaktion, Ratgeber von MICHEL-RedaktionDer "Michel Südamerika A-J 2023/2024" Ratgeber, herausgegeben von der Michel-Redaktion, ist eine umfassende Informationsquelle über die Länder Südamerikas, darunter Argentinien, Bolivien, Brasilien, Chile, Ecuador und Französisch-Guyana. Mit 1170 Seiten bietet dieses Sachbuch detaillierte Einblicke in die Kultur, Geografie und Reiseinformationen der Region. Die Publikation ist in deutscher Sprache verfasst und eignet sich sowohl für Reisende als auch für Studierende und Interessierte. Die handliche Grösse und das robuste Design machen es zu einem praktischen Begleiter für unterwegs. Die Michel-Redaktion ist bekannt für ihre präzisen und gut recherchierten Inhalte, die eine wertvolle Unterstützung bei der Planung von Reisen und dem Verständnis der südamerikanischen Kultur bieten.82,60 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Auer:Zur Aktualität der Privatrechtsthe, Fachbücher von Marietta AuerZiel der vorliegenden Abhandlung ist es, Reinachs Hauptwerk einem breiteren Publikum vorzustellen und damit einen nach hier vertretener Ansicht überfälligen Beitrag zu seiner Wiederentdeckung zu leisten. Dazu führt die Abhandlung zunächst in Reinachs Rechtsphänomenologie ein und weist Wege zu einer Reinach-Rezeption, die von phänomenologischen Denkvoraussetzungen weitgehend unabhängig sind. Die nachfolgenden Kapitel entfalten drei zentrale Grundbegriffe, auf denen das Gebäude von Reinachs Rechtstheorie aufruht: Versprechen als Grundbegriff des Schuldrechts, Gehören als Grundlage des Sachenrechts sowie Bestimmen als Ausgangspunkt der gesamten positiven Rechtsordnung. Das abschliessende Kapitel ordnet diese Erkenntnis in den Kontext alternativer rechtstheoretischer Entwürfe ein und fragt nach der Fruchtbarkeit einer heutigen Beschäftigung mit Reinachs Theorie. Das Ziel der Abhandlung ist erreicht, wenn es gelingt, die Brauchbarkeit von Reinachs sprachphänomenologischem Ansatz im Zusammenhang aktueller Privatrechtsdebatten zu erweisen. Das Thema der vorliegenden Abhandlung könnte daher kurz zusammengefasst auch lauten: Versprechen, Gehören, Bestimmen - Privatrecht erklärt durch drei performative Verben.29,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Boes, Waltraud: Brief - BerichtBrief - Bericht , Deutsch 3/4. Kopiervorlagen (3. und 4. Klasse) , Zündkabel & Zündkabelstecker > Elektrik & Zündungen , Erscheinungsjahr: 20200804, Produktform: Geheftet, Beilage: Broschüre drahtgeheftet, Titel der Reihe: Klippert Grundschule##, Autoren: Boes, Waltraud~Geißler, Nicole, Seitenzahl/Blattzahl: 76, Themenüberschrift: EDUCATION / Teaching Methods & Materials / General, Keyword: 3. und 4. Klasse; Deutsch; Grundschule; Texte schreiben, Fachschema: Deutsch / Lehrermaterial~Didaktik~Unterricht / Didaktik, Bildungsmedien Fächer: Deutsch/ Kommunikation, Fachkategorie: Didaktische Kompetenz und Lehrmethoden~Schule und Lernen, Bildungszweck: für den Primarbereich, Altersempfehlung / Lesealter: 23, Genaues Alter: GRS, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Unterrichtsmaterialien, Thema: Verstehen, Schulform: GRS, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Auer Verlag i.d.AAP LW, Verlag: Auer Verlag i.d.AAP LW, Verlag: Klippert Verlag, Länge: 296, Breite: 213, Höhe: 10, Gewicht: 237, Produktform: Geheftet, Genre: Schule und Lernen, Genre: Schule und Lernen, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Schulform: Grundschule, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch, WolkenId: 251276725,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.